Pekiştirmeli Öğrenme ile Adaptif Dövüş Robotu Eğitimi

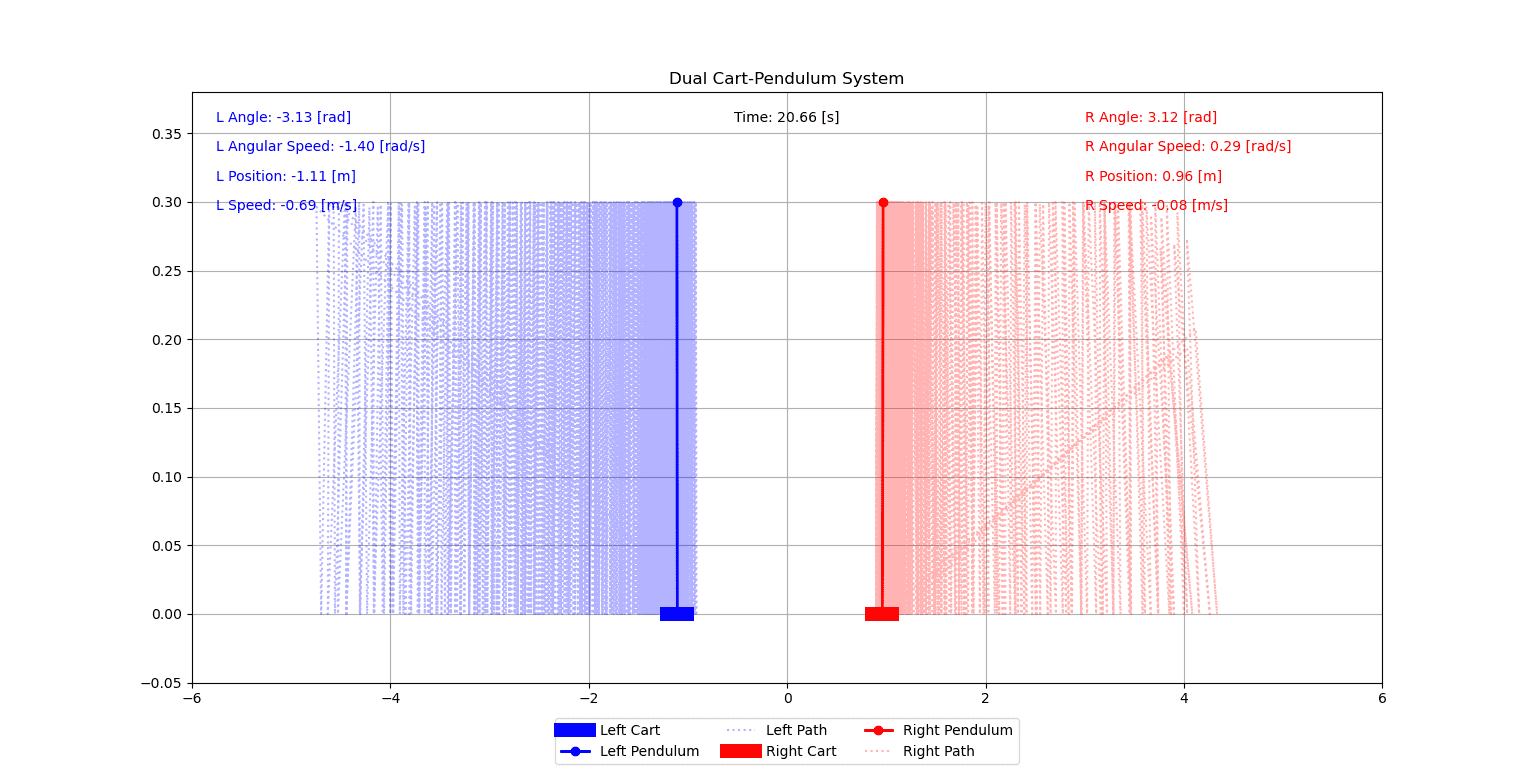
Ters sarkaç dinamiğinde analitik LQR ve Deep Q-Network mimarilerinin simülasyon ortamındaki stabilite, model kırılganlığı ve rekabetçi dayanıklılık analizi.
Ters sarkaç dinamiğiyle modellenen dinamik bir sistemde, hazır analitik modellemelere gereksinim duymadan denge kurma ve dış müdahalelere tepki verme kapasitesi Deep Q-Network mimarisi ekseninde araştırılmıştır. Temel referans noktası olarak analitik LQR kontrolcüsüyle başlanmış, ardından değişken zorluk eğrisine sahip aşamalı bir eğitim mimarisi izlenmiştir. Ajanın kendi kopyalarıyla kapalı döngüde rekabet etmesi, tek eksenli optimizasyonda görülen aşırı güven yanılgılarını sınırlandırmış ve sisteme öngörülemeyen fiziksel darbeler altında yüksek dayanıklılık kazandırmıştır.
ℹ️ Kapsam Notu: Bu çalışma akademik bir simülasyon araştırmasıdır; fiziksel bir robotik gövde inşa edilmemiş, algoritmik dayanıklılık dinamik fizik motoru üzerinde doğrulanmıştır.
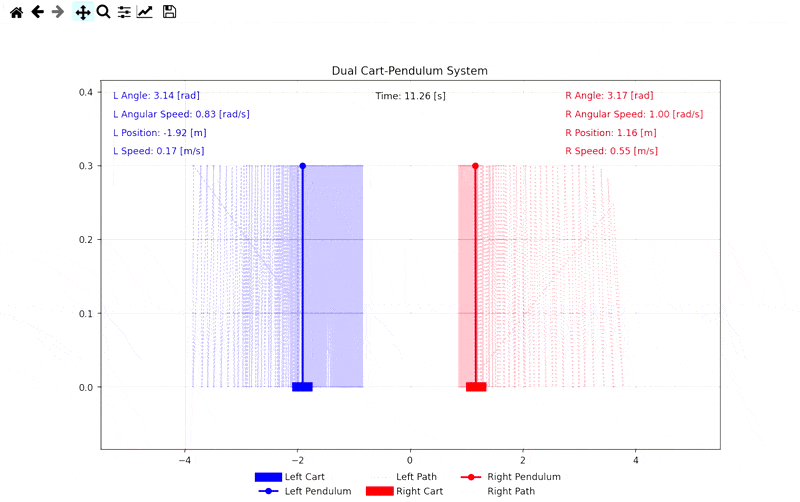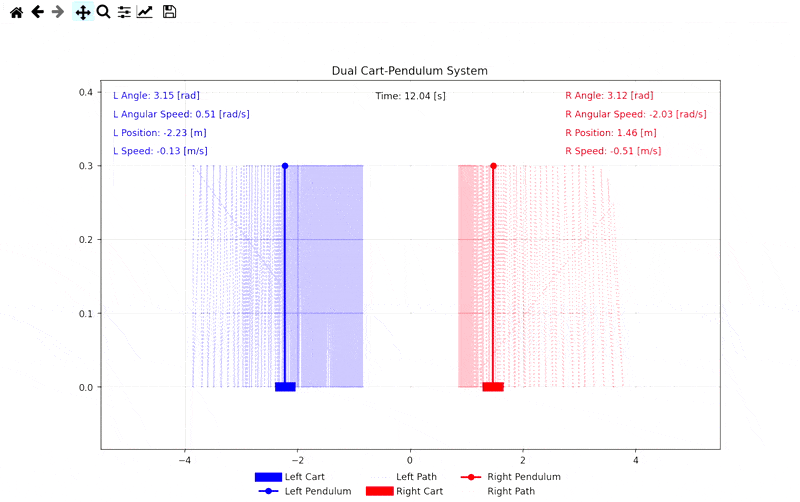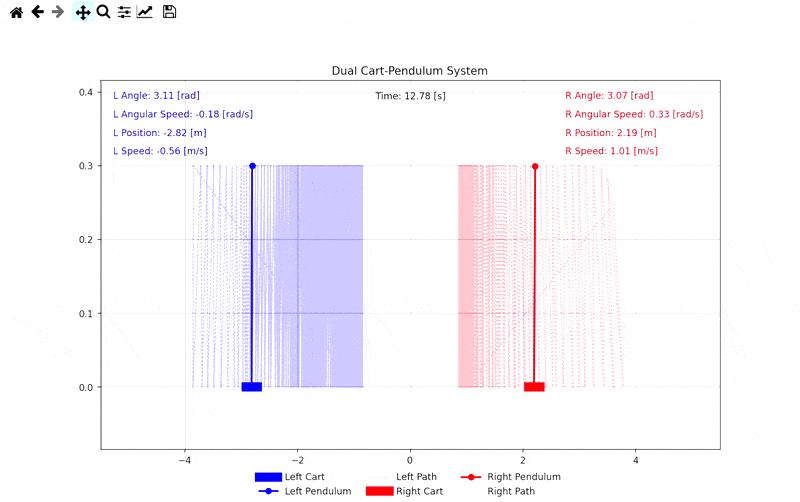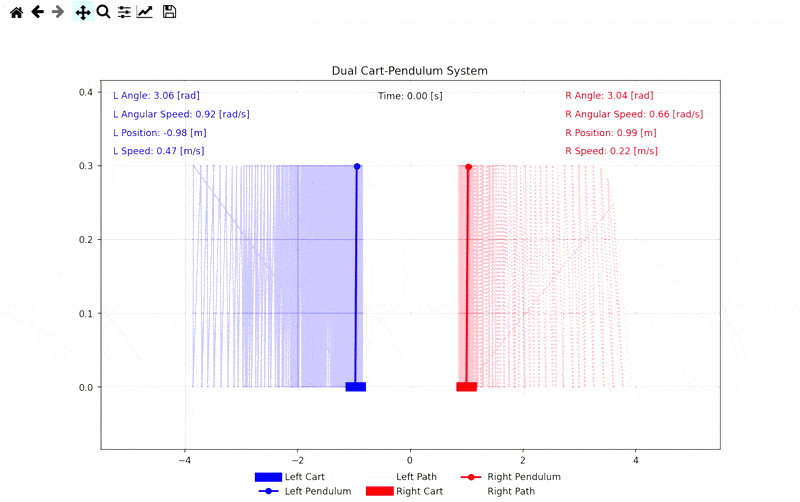
Proje Künyesi
|
Parametre |
Değer |
|---|---|
|
Kategori |
Çözüm Mühendisliği |
|
Teslimat Tipi |
Akademik Araştırma |
|
Durum |
Proof of Concept |
|
Ölçek / Kapsam |
4 Fazlı Eğitim Pipeline’ı, Self-Play Adversarial Training |
Mevcut Durum ve Sorun
Bağlam: Ters sarkaç düzenekleri yapısal olarak kararsız fiziksel sistemlerdir. Dışarıdan mekanik bir müdahale veya rekabet senaryosu gerektiren koşullarda, stabilizasyon ile reaktif hamle planlamasının aynı anda koordine edilmesi problemin boyutunu karmaşıklaştırır. Kritik Sorunlar: Sistem denklemlerinin açık olarak varsayılamadığı esnek operasyon alanlarında salt statik limitlere dayanan kalibreler yetersiz kalma eğilimindedir. Modelin yalnızca statik kurallar üzerinden optimize edilmesi, dinamik tehditler altında aşırı güven sonucu çöküş reaksiyonları gösterir.
|
Problem |
Detay |
|---|---|
|
Yapısal Kararsızlık |
Ters sarkaç modelinin sürekliliği için bitmeyen kapalı-döngü geri besleme ihtiyacı |
|
Çoklu Optimizasyon |
Cihazın kendi ağırlık merkezini koruması ve eşzamanlı pozisyonlama hesabı yapması |
|
Tanımsız Model |
Dışarıdan sağlanan hazır bir dinamik sistem transfer fonksiyonunun varsayılmaması |
|
Aşırı Güven Kırılganlığı |
Statik algoritmaların öngörülemeyen deterministik olmayan etkilere olan zayıf toleransı |
Çözüm Mimarisi ve Aksiyon
Mimari Yaklaşım: Eksik tanımlı kontrol ortamlarında oluşabilecek güven sapmalarını analiz etmek amacıyla, değişken zorluk eğrisi taşıyan 4 fazlı bir eğitim yapısı kurgulanmıştır.
Uygulanan Metodoloji:
Faz 1: LQR Referans Verisi Çıkarımı
Amaç: Karşılaştırmalı test ortamı oluşturmak amacıyla temel sistem dinamiklerini modellemek ve temel yanıtları kaydetmek.
- Dış kütüphane fonksiyonlarına bağımlı olmadan yalın bir LQR kontrolcü bloğu geliştirildi.
- CTMS Michigan modeli temel alınarak özelleştirilmiş simülasyon fizik motoru yapılandırıldı.
- Formüle edilen çıktı matrisleri (durum → eylem) referans model benchmarkı olarak arşivlendi.
Faz 2: Bireysel Stabilizasyon
Amaç: Sistemin hazır bir girdi haritası kullanmaksızın kendi hata fonksiyonlarıyla stabil kalma yeteneğini optimize etmesi.
- Deep Q-Network (DQN) ağ mimarisine geçiş yapılarak eğitim parametreleri atandı.
- Hesaplama kararlılığını sağlamak için Experience Replay ve Target Network gecikme döngüleri kullanıldı.
- Ödül fonksiyonu tasarımı: Açısal sapma, araba konum hatası ve kontrol eforu (harcanan kuvvet) cezalandırılarak sistemin dengeyi asgari enerjiyle koruması sağlandı.
Faz 3: Gürültü ve Saldırı Dayanıklılığı
Amaç: Kararlılığı test etmek için simülasyon ortamında fiziksel anomalilerin devreye alınması ve eylem uzayının ikiye ayrılması.
- Deterministik olmayan rastgele darbeler için Poisson dağılımı temelli ek dış kuvvetler yaratıldı.
- Sistem bu süreçte hem mekanik dengeyi muhafaza edip hem de planlı hareket sergileme parametrelerini ağırlıklandırdı.
- Temel denge kuvveti değişkeni ile saldırı kuvveti değişkeni bağımsız uzaylarda işlendi.
Faz 4: Modelin Kendi Kendine Dövüşmeyi Öğrenmesi
Amaç: İzole eğitimlerde oluşan aşırı güven yanılgısının karşılıklı dinamik baskı altında test edilmesi.
- Ağda ölçüm standardı sağlamak için iki farklı ajan profili aynı sinir ağı başlangıç ağırlıklarından türetildi.
- Eğitimin her bir periyodunda iki modül de kendi dengesini hesaba katarken diğer modülün denge fonksiyonunu zorlama mantığını yürüttü.
- Modüller statik bir fonksiyon parametresi yerine dinamik ve kendi tepkisine karşılık veren kopyasıyla simetrik olarak çapraz değerlendirmeye girdi.
Mimari Karar: İki bağımsız sinir ağı bloğu kullanılması kısa eğitim sürelerinde senaryo limitleri içinde model baskınlığı olarak adlandırılan asimetrik üstünlük sapmalarına neden olmuştur. Ortak sinir ağı topolojisine geçilerek bu hesap karmaşası dengelenmiş ve asimetrik sapmalar limitlere çekilmiştir.
İki Modlu İşletim Şartları:
- İzole Mod: Eğitim döngüsünün başlarında ortamda rekabet parametreleri inaktif olup sadece kartezyen denge izlemeye alınır.
- Kombine Mod: Parametreler belli bir olgunluğa geldiğinde denge vektörleri ile eş zamanlı olarak saldırı politikaları da aktifleştirilir.
Sistemdeki kontrol kaosunu önlemek adına saldırı eylemlerini ifade eden limit tavanı, denge fonksiyonlarına ait limitlerin yüzde 15’i oranında tutulmuştur. (Denge Toleransı: [-10, +10] N, Saldırı Toleransı: [-1.5, +1.5] N).
Sonuçlar ve Operasyonel Kazanımlar
|
Odak |
Tespiti Yapılan Etki |
|---|---|
|
Eşzamanlı Optimizasyon |
Mekanik stabilizasyon eğrileri ile reaksiyon yönlendirme işlemleri aynı süreç içerisinde değerlendirildi. |
|
Aşırı Güven Etkileri |
Self-play ağırlık güncellemeleri tatbik edilerek kapalı devre statik sistem varsayımlarının (aşırı güven) neden olduğu hatalar sınırlandırıldı. |
|
Sistem Dayanımı |
Adversarial baskı senaryolarında, klasik analitik hesaplamalı LQR referansına kıyasla daha sürdürülebilir esneklik limitleri çıkarıldı. |
|
Model Değişkenliği |
Formüle edilmiş nihai ve ideal sistem denklemleri dışarıdan girilmeden kontrol çıktıları saptandı. |
🎯 Test Sonuçları
|
Metrik |
Değer |
|---|---|
|
Test Bölüm Sayısı |
300 Episode |
|
Ortalama Simülasyon Süresi |
~320 Frame/Adım |
|
Gözlemlenen Tavan Seviye |
700 Frame/Adım |
|
Keşif Çarpanı |
0.0 (Sıfır keşif, saf politika) |
📊 Simülasyon Görselleri

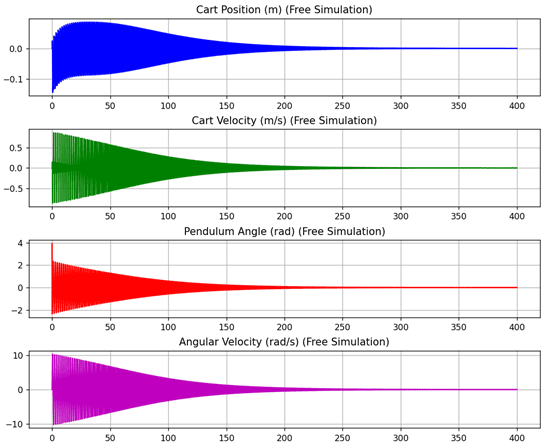
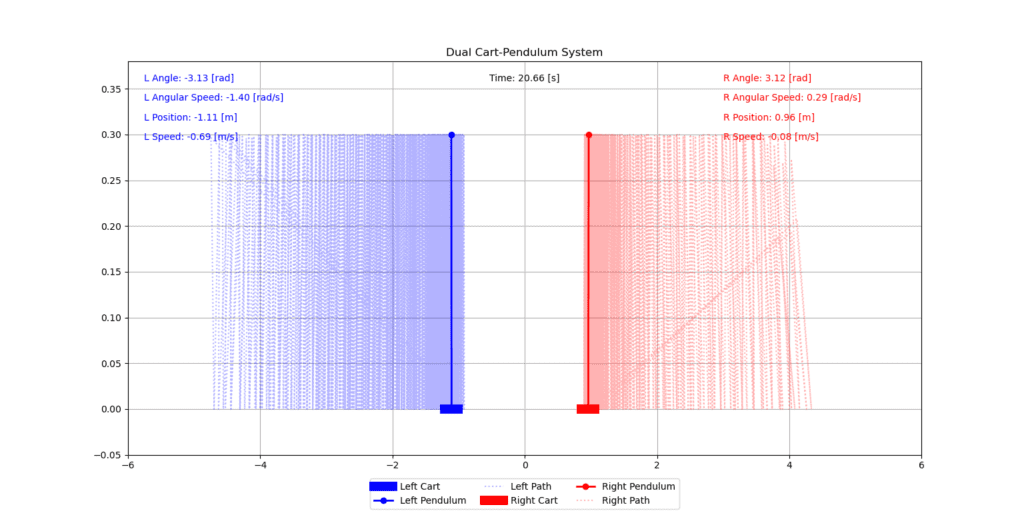
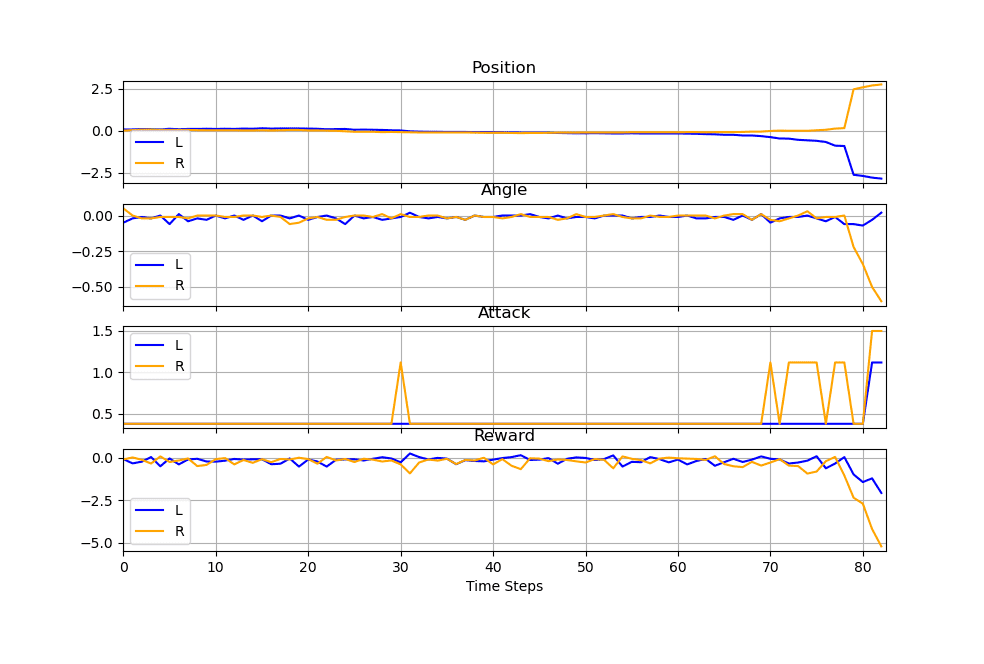
📥 İndirmeler
📄 Kaynak Makale PDF: Makina Öğrenmesi Teknikleri Kullanılarak Bir Dövüşen Robotun Eğitilmesi (PDF)
📋 İlgili Bağlantılar
🔗 İnceleme Yazısı: Klasik Kontrol Ölmedi: LQR ve Derin Pekiştirmeli Öğrenme Arasındaki Denge
📂 Kaynak Kodu: GitHub / neural-adaptive-control-simulation
Bu araştırma, İTÜ Kontrol ve Otomasyon Mühendisliği programı bitirme projesi kapsamında sunulmuştur.